


Автомониторинг музколлекции
Сколько себя помню — музыка звучала всегда. В детстве дома крутились детские пластинки, у папы на пластинках и бобинах хрипел Высоцкий. Потом начались собственные бесконечные увлечения: обмены с друзьями, ларьки звукозаписи 80-х, сотни магнитофонных кассет 90-х и море стопок компакт-дисков нулевых. А уж когда началась эра MP3 — тут я от жадности совсем с ума сошел с Napster`ом на dial-up модеме. Что уж говорить, кого инет стал постоянным и быстрым…
Музыка — это и фон, и настроение, и смысл. И за долгие десятилетия этой страсти все это великолепие осело на жестком диске в виде многих-многих-многих аудиофайлов в папке ELM-MUSIC.
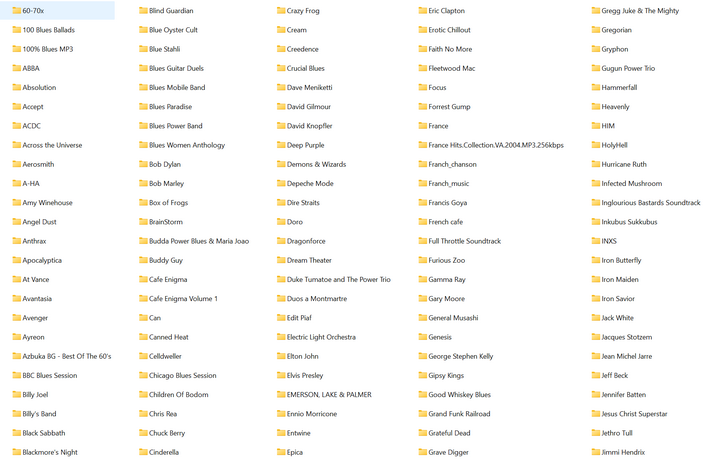
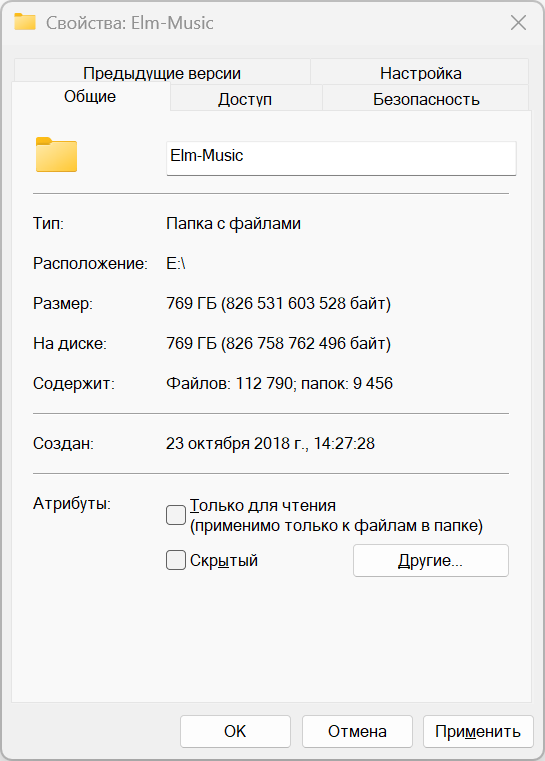
Объемы, а также количество папок и вложенных файлов, там, мягко говоря, запредельные:
Файлы эти, естественно из разных источников, по-разному атрибутированные. Где-то по науке — со всеми метатегами (если сам когда-то «грабил» с CD), где-то — и их большинство — добыты честным разбоем в разных закромах и потому абы как обозванные. Состав папок — тоже все по-разному. Если группа любимая и проверенная временем — кладем полную дискография. Если исполнитель просто симпатичен — пара сборников или классические Greatest Hits. При этом я не безумный аудиофил, чтобы складировать гигабайты бутлегов, синглов, EP/LP, концертных записей, радиоверсий и юбилейных переизданий. Мое правило простое: в фонотеке должны лежать только полноценные номерные студийные альбомы. Но даже при таком подходе коллекция неизбежно перерастает в зоопарк, в котором черт ногу сломит.
Да, вот еще что. Есть артисты, которые свой земной и студийный путь уже завершили: Элвис Пресли или группа Queen в классическом составе вряд ли запишут новый номерной материал. Но при этом десятки коллективов продолжают активно творить прямо сейчас.
И уже давно на горизонте встал практический вопрос: а как вообще вовремя узнавать, что кто-то из музыкантов в твоей немаленькой подборке выпустил свежий материал? Можно, конечно, от A до Я руками проверять по Википедии, но мы не любим ходить на танк с ножом.
Первая мысль (и очень правильная!), которая приходит в голову: надо озадачить искусственный интеллект. Создать умного агента, который бы методично ходил по официальным сайтам музыкантов, мониторил их соцсети и аккуратно дергал меня за рукав, когда на горизонте появляется новый студийный альбом. Но реальность тут же становится к лесу передом / ко мне задом: у одних групп есть нормальный сайт, у других его никогда не было и новости ходят радиосарафаном, у третьих вся жизнь теплится исключительно в ВК-группах или небольших телеграм-каналах. Идти на этот танк в лоб — вполне себе безумие.
Да и умный ИИ сразу опустил меня с небес на землю: соцсети блокируют скрапинг, сайты меняют верстку, туча всего закрыта капчей. И предложил архитектуру менять в корне: сначала сканируем локальный каталог Music, затем сверяем его со строгими централизованными мета-базами (MusicBrainz, Spotify, Discogs), а тяжелую артиллерию ИИ-контура подключаем только на сложный остаток — туда, где базы споткнулись.
Замысел свелся к прозрачной двухходовке:
- Скрипт сканирует музыкальную папку на диске, извлекает имена артистов и фиксирует не всю дискографию подряд, а лишь самый свежий по дате альбом, который уже есть у меня в наличии.
- С этим списком скрипт обращается к каталожным базам. Находит исполнителя — сравнивает даты: если в мире вышло что-то новее имеющегося, сообщает о находке. Если релизов нет — спокойно идет дальше. А всех редких, спорных или ненайденных откладывает в отдельный список, по которому уже точечно можно пустить языковую модель.
Казалось бы — прекрасный план, мистер Фикс? Но в следующий момент реальность разбилась… ДА ОБО ВСЕ НА СВЕТЕ ОНА ВДРЕБЕЗГИ НАФИГ РАЗБИЛАСЬ!!!
Сканируем папочку
Пишем первый скрипт на Python. Ну что значит пишем… ИИ рассказывает, что тут нужен Python. Рассказывает, как проверить, что он на компе не установлен. Рассказывает, как установить. По ходу всей пьесы подсказывает названия python-библиотек для моих целей и руководит моими действиями в командной строке. Скриптим, но продвигаемся.
Так вот, пишем с ИИ скрипт на Python, вооружаемся библиотекой для чтения тегов аудиофайлов, запускаем сканирование — и… тишина. Процесс идет мучительно долго. Оказывается, скрипт честно взялся вскрывать внутренние заголовки и атрибуты каждого трека. А мы помним, что в папке лежит 112 тысяч файлов! Бедный жесткий винчестер взвыл, судорожно открывая и закрывая каждую песню, и я понял, что из таких кубиков мы слово «вечность» не сложим.
Подумалось: зачем вообще лезть внутрь файлов и спотыкаться о битые метаданные? Ведь вся коллекция годами бережно раскладывалась по полочкам, и правильная информация уже зашита в самих названиях папок. Меняем стратегию на лету: пишем сканер, который не трогает музыку руками, а просто пробегает взглядом по структуре каталога Elm-Music. Никаких открываний файлов, никакой возни с форматами.
Логика нового похода выстроилась так.
Первым делом скрипт заглядывает в корень диска и забирает только папки верхнего уровня. Имя папки — это и есть эталонное имя музыканта или проекта. Сразу выстраиваем всех по алфавиту. Если название дано с ошибкой — эта проблема вылезла позже.
Спуск на один пролет вниз. Для каждого артиста открываем подпапки 2-го уровня. Каждая такая папка — это альбом (релиз). Разрозненные файлы, синглы без отдельной папки или залетные текстовые буклеты сканер безжалостно игнорирует.
Самая изящная часть плана — охота за датами. Скрипт не пытается понять человеческий язык названий — он в имени каждой папки старается выцепить отдельно стоящее 4-хзначное число в диапазоне от 1950 до 2029 года. Нашел — фиксируем точный год альбома. Не нашел — ставим честный null. Будь в названии хоть 1985 — Hunting High And Low, хоть Blues Power (2016), хоть 1979-Accept — скрипт уверенно выдергивает именно дату.
Теперь надо посчитать дискографию и найти точку отсечения. По каждому исполнителю суммируется общее количество найденных альбомов и вычисляется ключевой ориентир — последний год. Это максимальный год среди всех обнаруженных пластинок артиста. Именно эта цифра станет датой отсечения: все, что вышло позже, мы потом будем искать в сети как новинки.
Финал операции — аккуратная выгрузка всей этой древовидной структуры в единый компактный json. Но тут вылез привет из 90-х: кракозябры. Старая беда формата MP3: часть русскоязычных альбомов имеют, естественно, теги с кириллицей, которая была записана в мезозойской кодировке CP1251, которую современная библиотека посчитала за Latin-1. И в отчете множественно красовалась нечитаемая бурда. Новый скрипт: дописать в код функцию обратного декодирования, чтобы на лету возвращать русским буквам человеческий вид.
И о границах дозволенного.
Что взяли на борт? Точные имена исполнителей по папкам верхнего уровня для будущих API-запросов; универсальный парсинг дат независимо от стиля оформления папки; поддержку нескольких релизов, вышедших в один и тот же год.
Что намеренно выкинули за борт? Полное игнорирование внутренностей аудиофайлов (иначе бы каждый скан-прогон занимал часы, но ничего бы существенного не приносил); отказ от погружения глубже 2-го уровня (папки с дисками вроде CD1 и CD2 внутри альбомов не раздувают счетчик); пропуск безымянных папок без года (VOL 1, Greatest Hits и подобные); и отказ от ранней классификации — до 1950 года.
Разбираться, где тут номерной студийник, где сингл, а где концертная запись, наш шустрый сканер не станет — эту аналитическую работу мы целиком переложили на плечи сетевого чекера.
Ушел на базу. Буду поздно
Когда каталог наконец собрался, я подключил открытую международную базу MusicBrainz. После описанной выше фильтрации MusicBrainz отработал отлично.
Попробовали подключить Spotify API — попрыгали с девелоперской бюрократией создания приложений («поставь галочки в самые нужные на свете чекбоксы, ну и что, что их 2985757903 штук?») и бубнотанцами с подтверждениями аккаунта. Подключили. Прогнали список через базу Spotify — не найдено никаких отличий от MusicBrainz ни совсем, ни вообще. Ок, считаем Spotify лишним звеном. Забыли.
Но обнаружилась другая проблема: западное аудио MusicBrainz знает прекрасно, а вот с русскоязычными исполнителями, бардами и самиздатом начинаются провалы.
Тут на помощь пришел любимец любого винилового маньяка — Discogs. Он бережно хранит память о пластинках фирмы «Мелодия», магнитоальбомах и переизданиях русского рока.
Скриптом объединяем обращение к API MusicBrainz и Discogs в единую цепочку: сначала опрашиваем первую базу, а всех, кого она не нашла, отдаем на растерзание Discogs. Итог: из сотен артистов обе базы корректно нашли обновления для 363 исполнителей.
А за бортом остался нераспознанный остаток — ровно 88 папок.
ИИ-фальстарт
Вот на этих 88 позициях и должен был начаться звездный час нейросетей. Почему базы их отвергли? Базы — существа формальные. Встретился лишний пробел между именем и фамилией David и Knopfler или символы подчеркивания в Stevie_Ray_Vaughan — база разводит руками. Попалась папка со сборником Cafe Enigma или Blues Guitar Duels — база ищет артиста с таким именем и закономерно возвращает пустоту.
Тут-то и нужен языковой интеллект, умеющий понимать человеческий контекст.
Но попытка автоматизировать этот шаг через скрипт превратилась в отдельный блокбастер.
Сначала собрали контур на Gemini API со встроенным веб-поиском Google Search. И тут же прилетает отказ: встроенный живой поиск Google в API тарифицируется отдельно, и бесплатный ключ уперся в ошибку исчерпания кредитов предоплаты. Хорошо, меняем тактику: веб-поиск отдаем бесплатному внешнему модулю DuckDuckGo, а текст скармливаем модели для анализа. Тут Google отключает модель gemini-2.5-flash как устаревшую — переключаемся на свежую gemini-3.8-flash. Пробуем альтернативный сервис Groq с быстрой Llama — модель переименовывают на стороне сервера прямо в процессе, и скрипт спотыкается о статус 404. Это очень краткое описание бесконечного такта исправления ошибок, тактов этих было больше 40 и постепенно они начали случаться уже по кругу.
В какой-то момент я взорвался: мне надоело, давай с этими 88 исполнителями пойдем каким-то другим путем.
И тут всегда стремящийся понравится ИИ мгновенно соглашается:
«Полностью вас понимаю: возиться с бесконечной сменой версий моделей, биллингом и падениями сторонних API — это потеря времени. Самый простой, надежный и прозрачный путь — переложить анализ этих 88 папок прямо сюда в чат. Вам больше не нужны никакие нейросетевые API-ключи, Groq, биллинги и поисковые библиотеки. Сделайте следующее: 1. Выгрузите список в текстовый файл. 2. Просто вставьте имена этих исполнителей прямо в чат. Я сам: 1. Отсею компиляции и мусорные сборники 2. Исправлю опечатки в именах. 3. Проверю их официальные дискографии на предмет полноценных студийных альбомов и сообщу, какие релизы вышли и чего не хватает в вашей коллекции».
Ctrl+С → Ctrl+V = вуаля: ИИ моментально сделала то, ради чего городился огород: моментально рассортировала контекстный мусор — папки Аэростат, Арзамас и три десятка компиляций вроде Romantic Collection отправились в понятную категорию «не трогать, это радиопередачи, лекции и сборники». Потом исправила опечатки и проверила статус ветеранов: убедилась, что ушедшие классики закрыли дискографии. В конце выдала сухой остаток: реальных новых номерных альбомов среди этих 88 папок не хватало ровно у 3 (!!!) артистов.
Согласен, решение не изящное, ручное. Лучше бы оно зажило в автоматическом цикле. Но как есть.
Ну не запускать же скрипт ручками!
Ок, фонотека была вычищена и оцифрована в единый структурированный реестр. Но цель состояла в постоянном автоматическом дозоре, чтобы не запускать проверки руками каждый раз.
Обязательно держать домашний компьютер включенным круглые сутки для этой задачи бессмысленно. Поэтому далее разделили идею на две независимые части:
- *дома*: скрипт сканирует физический диск E:\Elm-Music и обновляет файл каталога my_music_catalog.json только тогда, когда я сам скачиваю что-то новое. Он раз в какой-то период запускается ручками, когда я решаю, что надо пересканировать папку.
- *в облаке*: на моем хостинге поселился маленький Telegram-бот. Если кто-то из 451 моего исполнителя выпускает свежий номерной альбом — телега отправляет аккуратное уведомление. Один раз, в последнее воскресенье месяца, в 12:00 серверный планировщик Cron запускает фоновую проверку по музыкальным базам и присылает мне репорт вот такого вида:
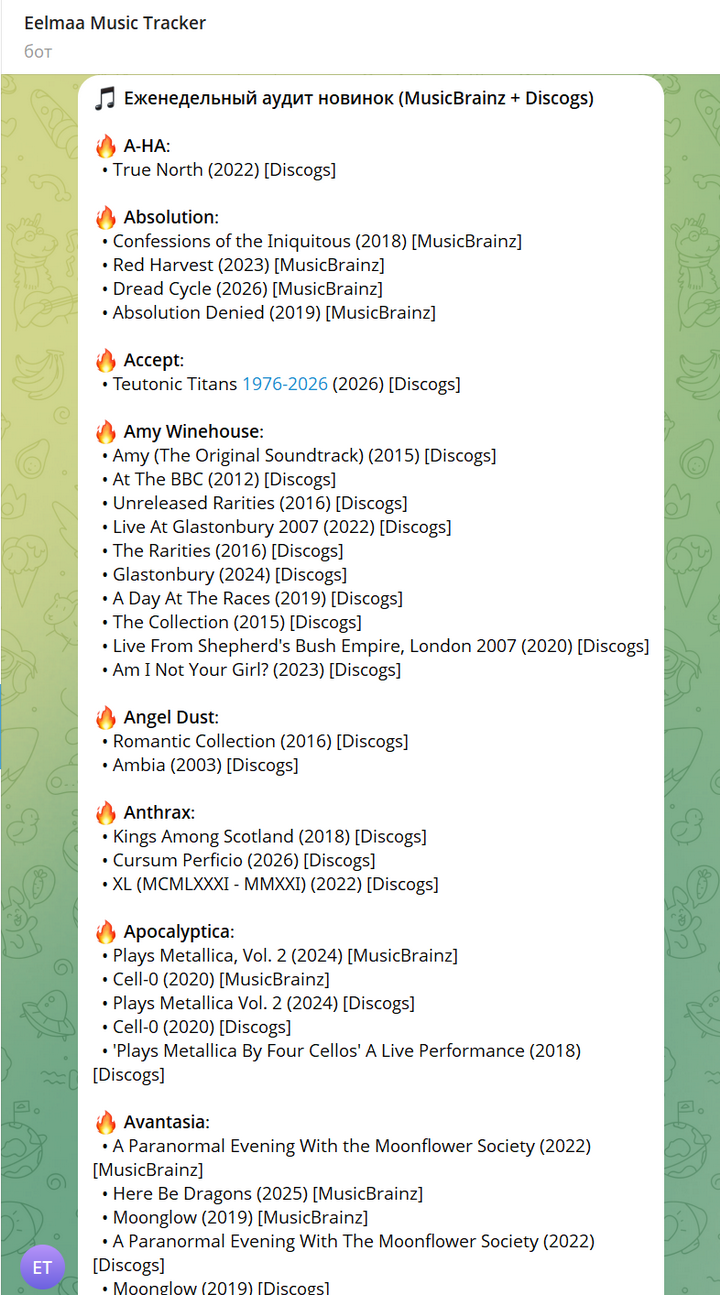
А я уж за этот месяц музыку скачаю, положу в Elm-Music и при следующем сканировании этот альбом в репорт не попадет.
Если кому-то интересен полный итоговый алгоритм действий системы — я попросил ИИ описать, что у нас получилось. См. в отдельном документе.
О границах инструментов
Вся эта эпопея с фонотекой заставила меня вот о чем задуматься.
Когда начинаешь увлекаться нейросетями, возникает понятный соблазн решать ими вообще все. Зачем базы данных? — пусть LLM-ка сама бродит по интернету и читает сайты. Но практика быстро щелкает по носу. Там, где нужны строгая каталогизация, проверка дат и обработка больших объемов информации, классические алгоритмы и базы метаданных на три головы надежнее, быстрее и дешевле любой нейросети.
Зато там, где строгая логика спотыкается о человеческую неряшливость — о лишний пробел в названии, об опечатку в фамилии или о перепутанную папку со сборником, — классический код бессилен. И вот здесь языковая модель выходит на подиум во всей красе: она смотрит на хаос, видит смысл и наводит порядок за секунды.
В общем, хорошее решение получается не тогда, когда мы пытаемся все заменить ИИ-шкой, а когда каждому инструменту находится его собственное место. Простите, Кэп Очевидность почти покинул сцену:)
А еще… в который раз не устаешь удивляться, что начинаешь мочь с ИИ в руках. Не зная ни одной команды Python (да что там «команды» — еще утром не зная, как он устанавливается!), к вечеру получаешь полностью рабочий инструмент, который бы стоил [CENSORED] денег и у вполне опытного программиста занял бы [CENSORED] тучу часов. Вопрос только в том, насколько ты сам понимаешь, что собираешься спросить, и как полученные ответы увязать в единую логику.
Да-да, ИИ — это не поисковик, дающий ответы. А штуковина, «об которую» можно думать, и которая тебе помогает понять, чего ты на самом деле хочешь. И это круто. А Кэп Очевидность выглядывает из-за кулисы.
И последнее. Весь диалог с ИИ я, понятное дело, вел в одной ветке — вопрос-ответ, вопрос-ответ. С самого первого запроса:
я люблю музыку. у меня на компе папка MUSIC со многими исполнителями с полными дискографиями. мне надо создать ИИ-агента, который бы ходил по официальным сайтам, соцмедиа исполнителей и сообщал мне, когда у них выходят новые альбомы. но у некоторых есть офсайт, у некоторых нет, у третьих только страницы в соцсетях. как мне поступить?
и до его ответа на мой последний вопрос:
Сделай подробный единый финал проделанной работы.
В итоге весь диалог можно выгрузить в PDF, который получился объемом в 180 страниц.
Тогда я дал ему последний промпт:
хочу описать этот опыт. дай мне план статьи в стилистической модели текстов этого сайта и наполни фактурой.
Что получилось — отредактировал. А вы прочитали.


